
NEAR 使用 DeepSeek 完成了 600 題數學題,正在將鏈上程式碼審計推向“白菜價”

作者:長安,深潮 TechFlow
深潮導讀: 672 道北美頂級大學生數學競賽題,被 NEAR AI 團隊用 Agent 全部解出。總計花費約 111 美元,平均每題 0.17 美元。NEAR AI 團隊調用中國開源模型 DeepSeek V4 完成了這次測試。這並非單純的大模型智慧競賽,在算力帳單背後,是一門試圖將昂貴的智能合約「形式化驗證」平民化的基礎設施生意。
一份開源程式碼庫的測試資料,將大模型解題的成本底牌攤在檯面上。
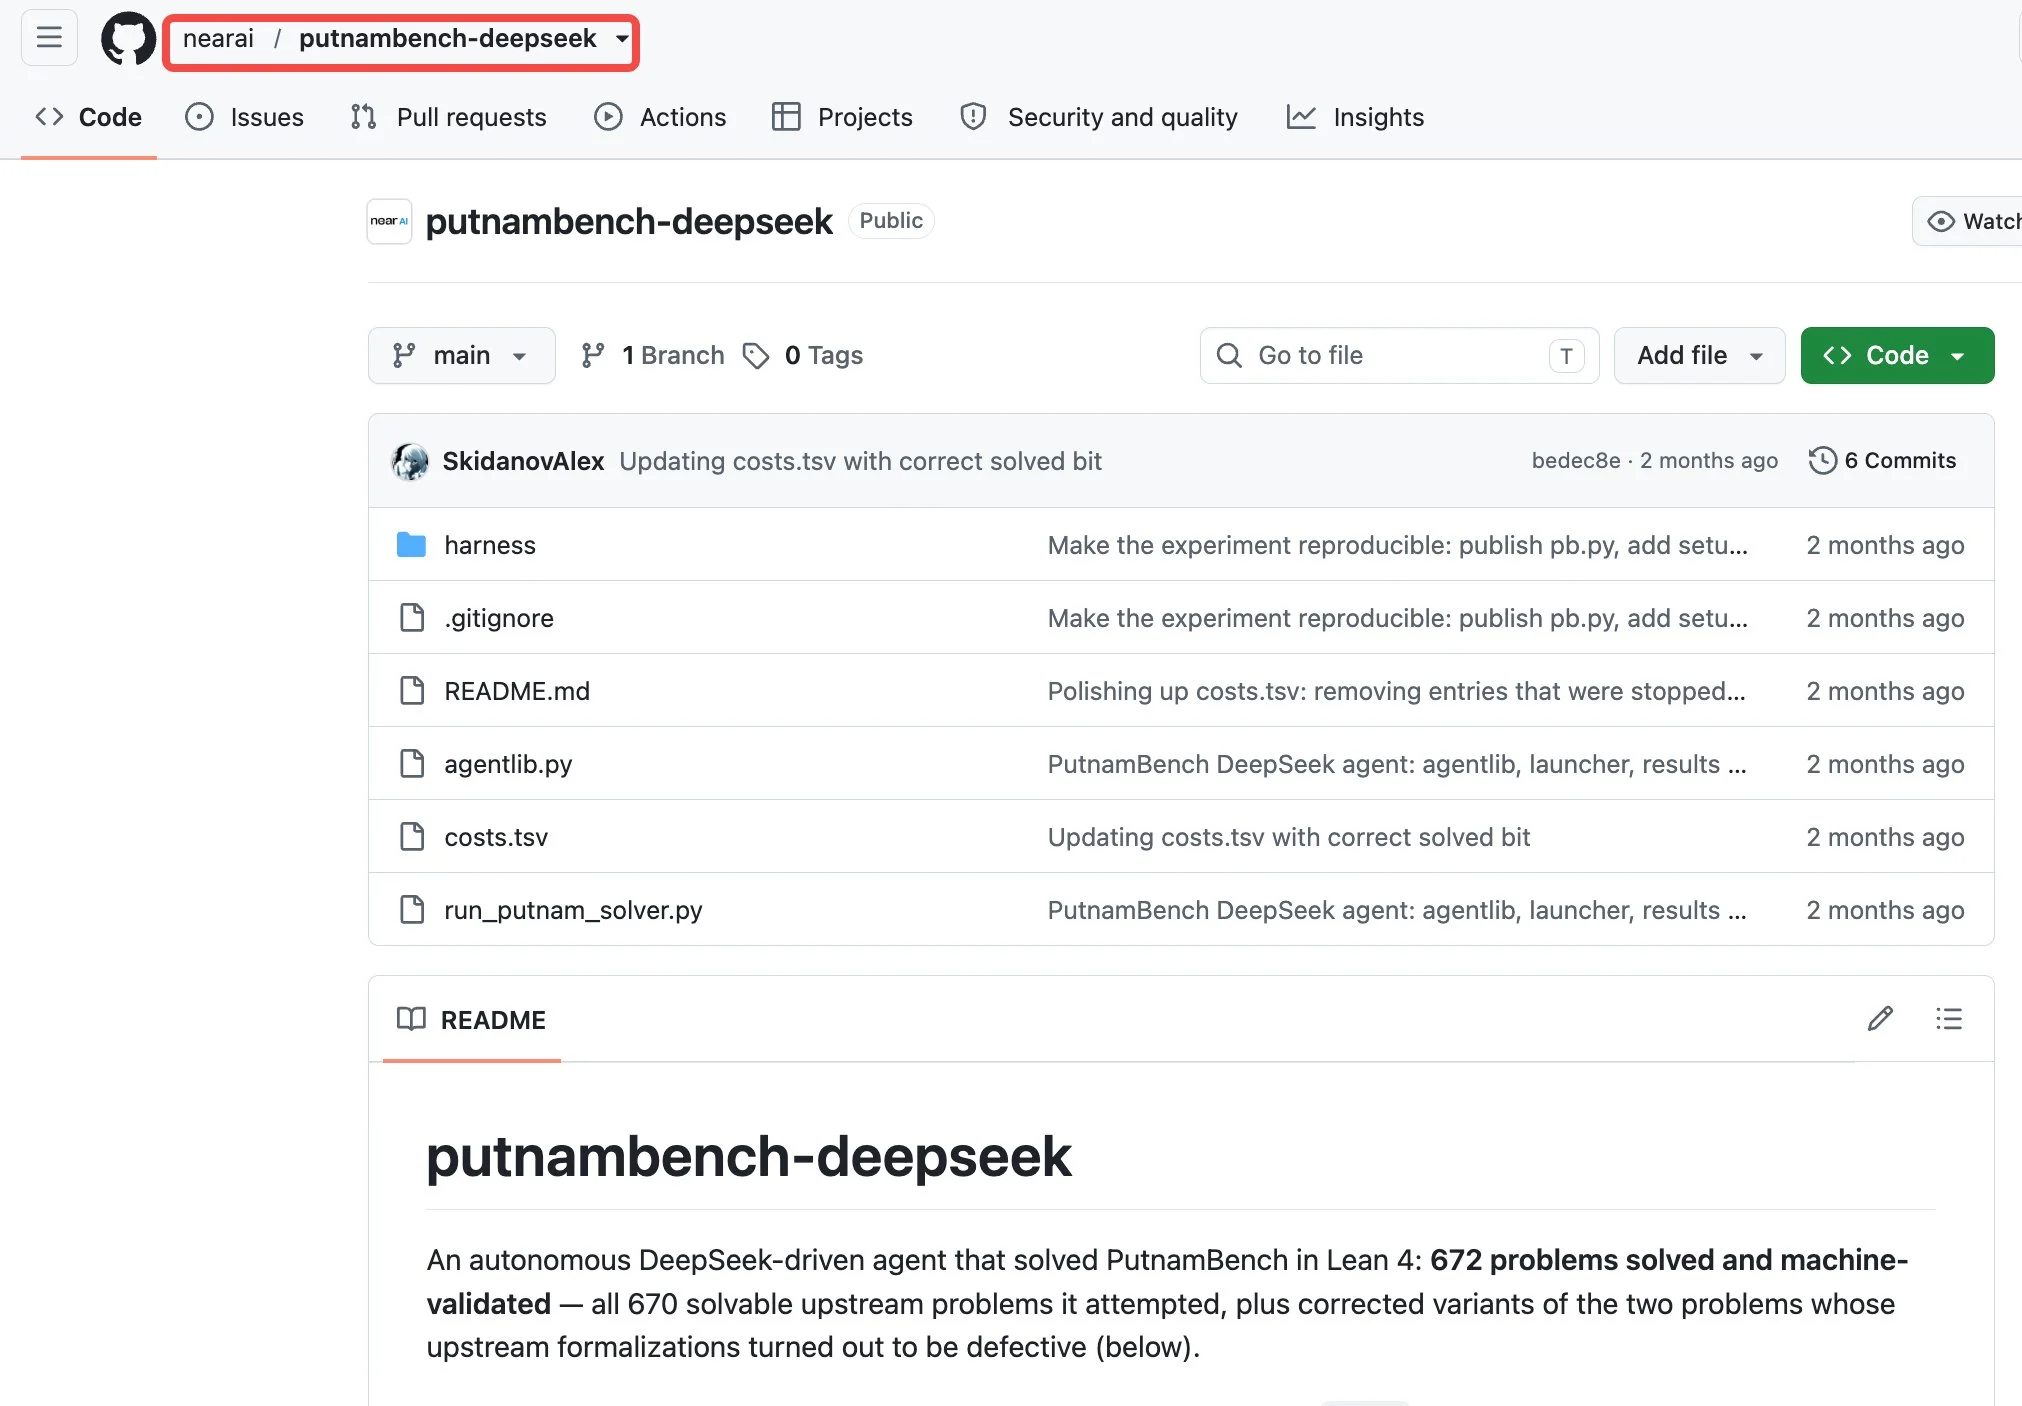
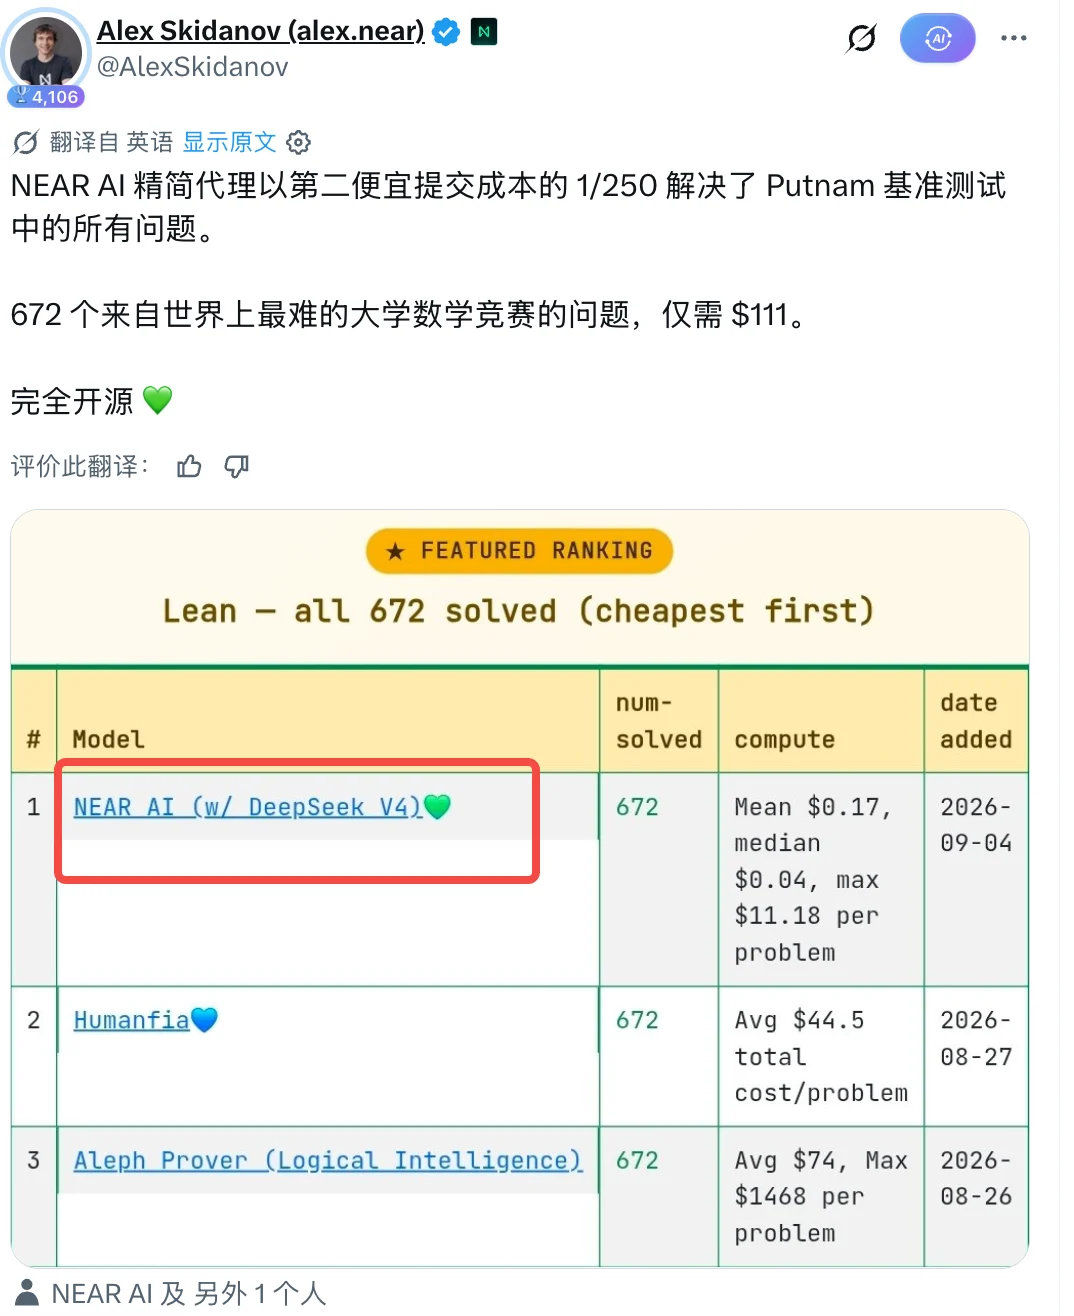
最近,根據 NEAR Protocol 聯合創辦人 Alex Skidanov 及官方側公布的數據,NEAR AI 的 Agent 解決了 PutnamBench 上的全部 672 道數學難題。
給不熟悉的讀者科普一下,PutnamBench 並非普通的題庫,它是將北美頂級本科數學競賽(William Lowell Putnam)題目形式化而成的基準測試。
簡單來說,就是讓 AI 做嚴密的數學邏輯推導,看看能否自主解題。NEAR AI 完成全部解答,花費約 111.85 美元。平均下來,每道題的成本是 0.17 美元。
作為對比,其他拿到滿分的方案帳單要昂貴得多。
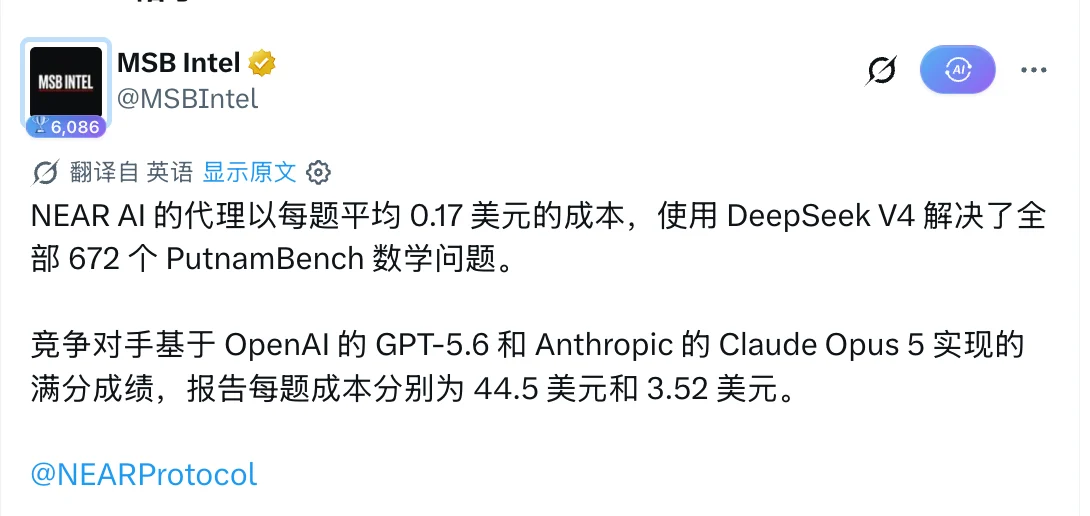
根據 MSBIntel 整理的數據,使用 OpenAI 的 GPT-5.6,單題平均成本高達 44.5 美元;使用 Anthropic 的 Claude Opus 5,每題也需要 3.52 美元。
在這個特定測試中,NEAR 採用 DeepSeek V4 的方案,將成本壓縮到了 GPT-5.6 的二百分之一。
公鏈解數學題,醉翁之意不在酒
公鏈團隊花力氣解數學題,指向的並非教育市場。
PutnamBench 測試的核心要求,是機器的可驗證性:AI 產出的不能只是一段文字答案,而是必須用 Lean 4(一種主流的證明助手語言)寫出嚴格的證明程式碼。
這些程式碼不能有語法漏洞,不能跳過推導步驟,必須被機器 100% 驗證通過。同時,這在計算機科學領域對應著一項關鍵技術,即形式化驗證。
而關聯到加密行業,智能合約承載著數億甚至上百億美元的資金。傳統的程式碼審計依賴人工尋找漏洞,而形式化驗證則是用嚴密的數學邏輯,一行行證明程式碼在所有可能狀態下都不會出錯。
長期以來,形式化驗證的致命缺點是貴且慢。它需要頂尖的安全專家和漫長的周期,通常只有資金雄厚的頂級項目才負擔得起。
NEAR AI 這次的測試,證明了用開源 AI 模型批次產生可靠數學證明的可行性,更驗證了其低成本。
鏈上安全的平民化基礎設施
將形式化驗證的門檻壓低至幾毛錢,這正是 NEAR 正在布局的實際業務。
目前,這套打通了 DeepSeek 和 Lean 4 的代碼已經完全開源。NEAR 官方公開的下一步方向,是直接將這套低成本工具應用於 NEAR Protocol 自身以及核心智能合約的安全驗證上。
因此,你可以把它理解成這是一場技術下放,或者更通俗地說就是項目方在做事,和 AI 敘事相關。
如果開源 AI 能夠穩定產出機器可驗證的代碼安全證明,代表未來的普通開發者和小型團隊,也可以在部署合約前,用幾毛錢的成本跑一次形式化驗證,降低智能合約出現問題的機率。
不過客觀來說,這與 NEAR 代幣的短期價格漲跌沒有直接關聯。但在公鏈生態的底層競爭中,用幾十美分去踩雷,遠比事後花上百萬補救更具真實的商業價值。
免責聲明:文章中的所有內容僅代表作者的觀點,與本平台無關。用戶不應以本文作為投資決策的參考。
您也可能喜歡
更新版 1-滙豐因中東局勢及人工智能風險將全球股票評級下調至「中性」
巴西股票ETF(EWZ.N)暴跌26%,創歷史最大跌幅
Anthropic目標於11月16日當週進行首次公開募股(IPO)
BUZZ-Roth MKM因歐洲業務惡化及首席執行長交接存在不確定性,下調LKQ評級
加密貨幣價格
更多


