
エージェント時代のCPU路線争い:NVIDIAは「単一コアの高速化」に賭け、AMDは「より多くの並列処理」に賭ける

NVIDIAとAMDが競っているのは、単にどちらのCPUが速いかということではなく、AI時代のCPUの評価基準を誰が定義するかという点だ。
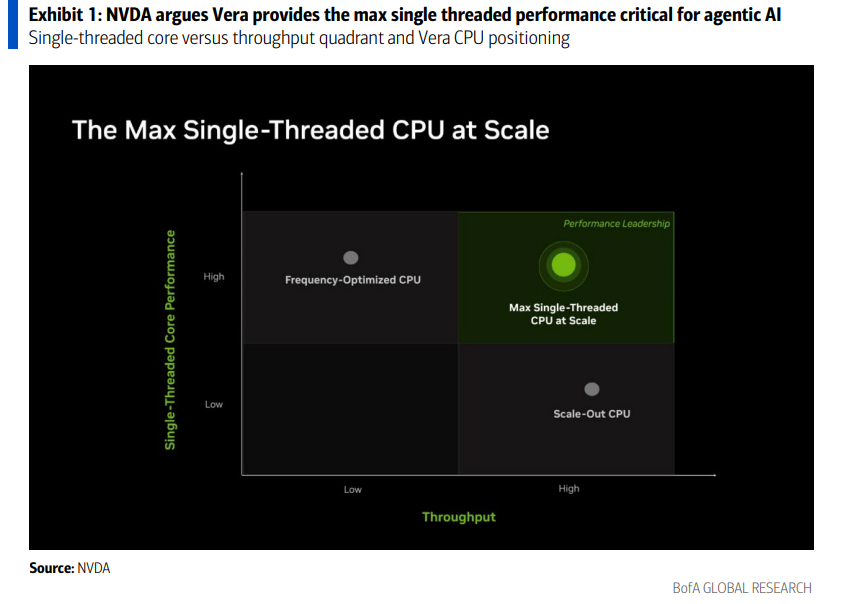
NVIDIAは最近、Vera CPUアーキテクチャの詳細な技術情報を公開した。このプロセッサは自社開発のOlympus ARMアーキテクチャコア88個を搭載し、メモリ帯域幅は1.2TB/s、オンチップインターコネクト帯域幅は3.4TB/sとなっている。NVIDIAの主張の核心は、AI Agentの動作はCPUとGPUが繰り返しかかわり合うことで成り立つ、つまりツール呼び出し、コード実行、データ検索、タスクオーケストレーションなどの各段階がすべて前のステップの完了に依存するため、CPUのシングルコア速度とレイテンシがエージェント全体の応答効率を直接決定するということだ。
7月23日、風を追うトレーディングデスクのニュースによると、Bank of America SecuritiesのアナリストVivek Aryaは最新のレポートで、Veraの発表が業界に新たな評価フレームワーク―「大規模化における最大シングルスレッド性能」―を持ち込んだと指摘。この考えはAMDが長年主張してきたチップレットによるマルチコアスタック路線とは直接対立するものであり、同アナリストはこの論争を「Agent型AIは単一タスクの完了時間で詰まるのか、それとも1つのラックで同時に処理できるタスク数で詰まるのか?」と位置付けている。AMDは今週木曜日にAI 2026テクノロジーデイを開催し、このフレームワークに公式に初めて応答する見込みだ。
この論争の背景には、サーバー向けCPU市場がAI需要によって再構築されつつあり、2030年には市場規模が現在の約4倍、1700億ドルに達すると予想されていることがある。これは既存規模のシェア争いではなく、新たに形成される成長市場だ。業界で認められるパフォーマンス評価基準を先に確立した者が、価格決定とナラティブの主導権を握る。
NVIDIAの論理:Agentの処理速度が重要、同時実行数よりも大事
NVIDIAによるAgentのワークフローの説明はきわめて具体的だ。Agentがタスクを進める過程で、CPUとGPUの間には大量の直列的なやり取りが発生し、各呼び出しは前の処理が終わって初めて継続できる。つまり、一つでもプロセスの遅延があるとその分レイテンシが蓄積・増幅され、最終的にAIファクトリー全体の生産効率が低下する。
このロジックにおいて、シングルコア性能は単なるスペック値ではなく、GPUのリソース活用率を左右する重要な変数となる——CPUが速ければ速いほど、GPUの待機時間は短くなり、システム全体のリソース利用効率は向上する。つまりコアが速いほど全体の応答速度が速くなる。
Veraにはもう一つ注目すべき設計ポイントがある。NVIDIAはチップレット分離アーキテクチャではなく単一計算ダイ(monolithic die)を選択したが、その理由は前者のほうが「スケーラブルな一貫性」を提供できるからだという。これはAMDが長年推進してきたチップレット路線とは対立しており、両社のアーキテクチャ哲学の根本的な対立が明確になったことを意味する。
さらにVeraは単体製品ではなく、NVIDIA全体のAIインフラエコシステムにおける「協調設計」の一部として、Rubin GPU、Groq LPX、Spectrumスイッチ、BlueFieldストレージ/ネットワークカードと連携して動作する。このシステム全体での統合こそ、NVIDIAが単一ハードウェア比較にとどまらない真の競争優位である。
AMDの反論:現実のAI生産現場では並列処理能力が勝負
AMDのスタンスは「現実の生産環境」の違った定義に基づいている。
AMDの視点では、本番AIシステムは一つのAgentが逐次処理するものではなく、データベース、API、ベクトルストア、オーケストレーションエンジン、キャッシュやミドルウェアなどで構成される分散型ソフトウェアプラットフォームに近い。このような環境では、ボトルネックは単一タスクの処理速度ではなく、一定の消費電力内で同時にどれだけ多くのワークフローを抱えられるかにある。
AMDは具体的な推計も示している。シミュレートされた100kWラック導入のシナリオでは、EPYC 9965(Turin)のラックレベルスループットはNVIDIA Vera基準の約2.4倍、次世代EPYC 6(Venice)は3.3倍に達すると見込まれる。
AMDの論理はこうだ:スループット密度が高いほど、同じ消費電力でより多くのユーザーにサービスでき、より多くのリクエストを処理できる——これこそクラウドAI導入の本当のコスト関数だ。
AMD x86かNVIDIA ARMか:ソフトウェアイコシステムが見えない主戦場
CPUアーキテクチャの争いは命令セットのレイヤーにも広がっている。
NVIDIAはARMアーキテクチャを選択し、「マイクロアーキテクチャが十分優れていれば、命令セットの互換性は二の次でも良い」と暗黙の立場を示している。しかしAMDとIntelは、今週の木曜日以降も「AIがモデル推論からエンタープライズソフトウェアワークフローへと拡大しつつある今、エンタープライズ向けソフトウェアはデータベース、ミドルウェア、セキュリティプラットフォーム、業務アプリケーションなどのレイヤーでx86系エコシステムによる数十年にわたる最適化と信頼性・互換性を蓄積してきた」という点を強調し続ける見通しだ。
これは単なる技術論争ではない。AIワークロードが次第に企業の既存ITシステムに組み込まれるにつれ、ソフトウェアエコシステムの歴史的蓄積は、ハードウェアのピーク性能以上に代替困難なものとなりうる。NVIDIAがVeraでこれらのシナリオに参入できるかどうかは、ARMのソフトウェアエコシステムの成熟速度に大きく左右されるだろう。
標準争い:次のCPU KPIは誰が決める?
2つのフレームワーク、2つのKPI、本質は両社が業界ナラティブの主導権をめぐって争っているということである。
NVIDIAのフレームワークはレイテンシ、シングルスレッド進捗、GPU利用率にフォーカスし、AMDのフレームワークは並列度、スループット、サービス密度を軸にしている。
ポイントは、市場が最終的にどの指標を使ってサーバー向けCPUを調達することになるかだ。
Bank of Americaの見方では、AMDの木曜日のイベントで最も重要なのはベンチマークデータで対抗相手を圧倒することではなく、自社の評価基準を業界に理解・納得させることだとしている。どちらのフレームワークがデータセンターバイヤーに受け入れられるかが、この1700億ドル規模市場で価格決定権を握る鍵となる。
NVIDIAに対してNVDAの「買い」格付けを維持し、目標株価は350ドル(現在価格207.29ドル)とした。
免責事項:本記事の内容はあくまでも筆者の意見を反映したものであり、いかなる立場においても当プラットフォームを代表するものではありません。また、本記事は投資判断の参考となることを目的としたものではありません。
こちらもいかがですか?
米国株式市場まとめ|主要3指数が揃って下落、10年米国債利回りが約20年ぶりの高水準に 原油価格は変動、金は約4%下落
取引終了時点で、ダウジョーンズ指数は347.11ポイント下落し、下落率0.67%、51481.51ポイントとなった。S&P500指数は59.72ポイント下落し、下落率0.77%、7683.69ポイントとなった。ナスダック総合指数は248.34ポイント下落し、下落率0.92%、26820.38ポイントとなった。
トランプ氏、中間選挙の重要州アイオワを狙う:150億ドル規模の製鉄所建設計画を発表、8000人の雇用創出へ
トランプ氏は、この工場が建設されれば年間1,000万トンの鉄鋼生産が可能となり、「米国最大の鉄鋼工場となる」と述べた。ホワイトハウスの担当者は、工場は早ければ2030年にも製鉄を開始でき、約8,000人の雇用創出が見込まれると発表した。ただし、工場の経済効果は今年11月の大統領選前には現れない。重要な農業州であるアイオワは、ディーゼル価格の高騰と関税摩擦という二重の負担に直面しており、トランプ氏の今回の行動には明らかな政治的意図が見られる。
AMDが82億ドルでWorld Labsを買収、リーフェイフェイがチーフサイエンティストに就任
AMDは、AIの先駆者である李飛飛(Fei-Fei Li)氏が共同創業したAIスタートアップWorld Labsを、約82億ドル相当の全株式取引で買収しました。World Labsは空間インテリジェンスと3D環境シミュレーションに特化しています。取引完了後、李飛飛氏はAMDの執行副社長兼チーフサイエンティストに就任する予定です。この動きは、AMDがモデル研究の能力をチップ設計の推進力として内製化し、ロボティクスやシミュレーションなどの物理AI分野でNvidiaと正面から競争する意図があることを意味します。
暗号資産価格
もっと見る


