
Nvidia lancia la nuova generazione della piattaforma Rubin, il costo dell'inferenza è dieci volte inferiore rispetto a Blackwell, spedizioni previste per la seconda metà dell'anno

Nvidia ha presentato la nuova generazione della piattaforma Rubin AI al CES, segnando il mantenimento di un ritmo di aggiornamento annuale nel settore dei chip per intelligenza artificiale (AI). Integrando sei nuovi chip, la piattaforma offre notevoli miglioramenti in termini di costi di inferenza ed efficienza di addestramento, e la consegna ai primi clienti è prevista per la seconda metà del 2026.
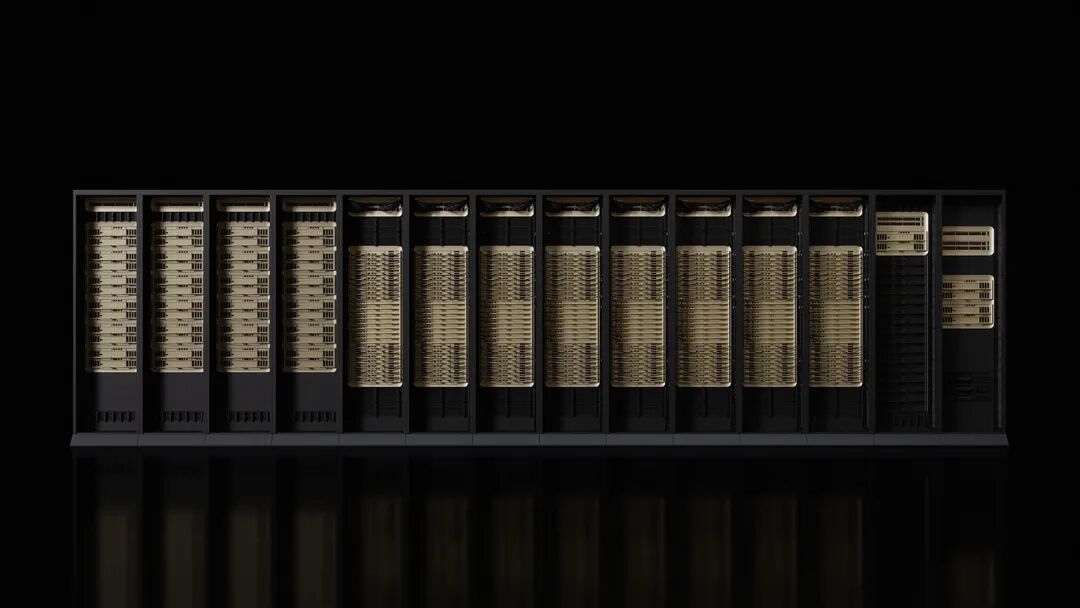
Lunedì 5, ora della costa orientale degli Stati Uniti, Jensen Huang, CEO di Nvidia, ha dichiarato a Las Vegas che i sei chip Rubin sono tornati dai partner produttivi e hanno già superato alcuni test chiave, procedendo secondo i piani. Ha sottolineato che "la corsa all'AI è iniziata, tutti stanno lavorando per raggiungere il prossimo livello". Nvidia ha evidenziato che i sistemi basati su Rubin avranno costi operativi inferiori rispetto alla versione Blackwell, poiché possono ottenere gli stessi risultati con meno componenti.
Microsoft e altri grandi fornitori di cloud computing saranno tra i primi clienti a implementare il nuovo hardware nella seconda metà dell’anno. La prossima generazione della super-fabbrica AI Fairwater di Microsoft sarà dotata del sistema rack-level Nvidia Vera Rubin NVL72, scalabile fino a centinaia di migliaia di superchip Nvidia Vera Rubin. CoreWeave sarà anch’esso tra i primi fornitori a offrire sistemi Rubin.
Il lancio della piattaforma arriva in un momento in cui una parte di Wall Street è preoccupata per l’aumento della concorrenza che Nvidia deve affrontare e mette in dubbio la sostenibilità degli attuali livelli di spesa nel settore AI. Tuttavia, Nvidia mantiene una previsione rialzista a lungo termine, stimando che il mercato totale indirizzabile possa raggiungere migliaia di miliardi di dollari.
Miglioramenti delle prestazioni per le nuove esigenze dell’AI
Secondo l’annuncio di Nvidia, le prestazioni di addestramento della piattaforma Rubin sono 3,5 volte superiori a quelle della generazione precedente Blackwell, mentre le prestazioni nell’esecuzione di software AI sono aumentate di 5 volte. Rispetto a Blackwell, Rubin può ridurre fino a 10 volte il costo di generazione dei token di inferenza e diminuire di 4 volte il numero di GPU necessarie per l’addestramento di modelli Mixture of Experts (MoE).
La nuova piattaforma è dotata della CPU Vera con 88 core, che offre prestazioni doppie rispetto ai prodotti sostitutivi. Questa CPU, progettata specificamente per l’inferenza agentica, è il processore più efficiente per le grandi fabbriche AI, dotata di 88 core personalizzati Olympus, piena compatibilità Armv9.2 e una connessione NVLink-C2C ultra-rapida.
La GPU Rubin è dotata della terza generazione di motore Transformer, con funzionalità hardware di compressione adattiva accelerata, offrendo 50 petaflops di potenza di calcolo NVFP4 per l’inferenza AI. Ogni GPU fornisce una larghezza di banda di 3,6TB/s, mentre il rack Vera Rubin NVL72 offre 260TB/s di larghezza di banda.
Test dei chip in corso con successo
Jensen Huang ha rivelato che tutti e sei i chip Rubin sono rientrati dai partner produttivi e hanno superato i test chiave che ne dimostrano la prontezza per il dispiegamento secondo i piani. Questa dichiarazione sottolinea come Nvidia mantenga la sua posizione di leader nella produzione di acceleratori AI.
La piattaforma include cinque tecnologie innovative: la sesta generazione della tecnologia di interconnessione NVLink, il motore Transformer, il confidential computing, il motore RAS e la CPU Vera. In particolare, la terza generazione della tecnologia confidential computing rende Vera Rubin NVL72 la prima piattaforma rack-level a offrire protezione dei dati cross-CPU, GPU e domini NVLink.
La seconda generazione del motore RAS copre GPU, CPU e NVLink, offrendo monitoraggio in tempo reale, tolleranza agli errori e manutenzione proattiva per massimizzare la produttività del sistema. Il rack adotta un design modulare e senza vassoi di cavi, con velocità di assemblaggio e manutenzione 18 volte superiori rispetto a Blackwell.
Ampio supporto dall’ecosistema
Nvidia ha dichiarato che Amazon AWS, Google Cloud, Microsoft e Oracle Cloud saranno tra i primi a implementare istanze basate su Vera Rubin nel 2026, seguiti dai partner cloud CoreWeave, Lambda, Nebius e Nscale.
Sam Altman, CEO di OpenAI, ha affermato: “L’intelligenza cresce con la potenza di calcolo. Più calcolo aggiungiamo, più i modelli diventano potenti, risolvendo problemi sempre più complessi e avendo un impatto maggiore sulle persone. La piattaforma Rubin di Nvidia ci aiuta a continuare questa espansione.”
Dario Amodei, cofondatore e CEO di Anthropic, ha affermato che “l’efficienza della piattaforma Rubin di Nvidia rappresenta un progresso infrastrutturale che permette una memoria più estesa, un ragionamento migliore e output più affidabili”.
Mark Zuckerberg, CEO di Meta, ha dichiarato che “la piattaforma Rubin di Nvidia promette cambiamenti radicali in termini di prestazioni ed efficienza, necessari per implementare i modelli più avanzati su scala di miliardi di persone”.
Nvidia ha inoltre dichiarato che Cisco, Dell, HPE, Lenovo e Supermicro prevedono di lanciare vari server basati su prodotti Rubin. AI lab come Anthropic, Cohere, Meta, Mistral AI, OpenAI e xAI attendono di poter utilizzare la piattaforma Rubin per addestrare modelli più grandi e potenti.
Dettagli dei prodotti annunciati in anticipo
I commentatori hanno osservato che quest’anno Nvidia ha svelato i dettagli dei nuovi prodotti prima del solito, una mossa volta a mantenere il settore dipendente dall’hardware dell’azienda. Nvidia di solito presenta in dettaglio i suoi prodotti durante l’evento GTC che si tiene ogni primavera a San Jose, California.
Per Jensen Huang, il CES è solo una delle tante tappe del suo tour maratona di eventi. Annuncerà prodotti, partnership e investimenti in vari eventi, tutti con l’obiettivo di accelerare l’adozione dei sistemi AI.
L’hardware appena annunciato da Nvidia include anche componenti di rete e connettività, destinati a far parte del supercomputer DGX SuperPod, ma disponibili anche come prodotti modulari separati per i clienti. Questo miglioramento delle prestazioni è essenziale poiché l’AI si orienta verso reti di modelli più specializzati, non solo filtrando grandi quantità di input ma anche risolvendo problemi specifici attraverso processi multi-fase.
Nvidia sta promuovendo applicazioni AI in tutti i settori economici, inclusi robotica, sanità e industria pesante. Come parte di questo sforzo, Nvidia ha annunciato una serie di strumenti volti ad accelerare lo sviluppo di veicoli a guida autonoma e robot. Attualmente, la maggior parte della spesa informatica basata su Nvidia proviene dal budget di capitale di pochi grandi clienti, tra cui Microsoft, Google Cloud di Alphabet e AWS di Amazon.
Esclusione di responsabilità: il contenuto di questo articolo riflette esclusivamente l’opinione dell’autore e non rappresenta in alcun modo la piattaforma. Questo articolo non deve essere utilizzato come riferimento per prendere decisioni di investimento.
Ti potrebbe interessare anche
La dissoluzione delle “transazioni di consenso” e la nascita di un nuovo consenso! Goldman Sachs spiega: perché le istituzioni stanno attualmente riducendo significativamente le posizioni in AI
Le operazioni "long AI, short tutto il resto", estremamente affollate, stanno subendo una dolorosa decostruzione: il mercato non si accontenta più della "narrazione del bruciare denaro", e i cloud provider di scala ultra-massiccia devono mostrare una reale conversione dei ricavi mentre spendono 1.100 miliardi di dollari in investimenti. Il deficit di energia da 40-50 gigawatt, i costi di capitale in aumento e il cambio del paradigma macroeconomico verso un'epoca di "spese eccessive" stanno trasformando le operazioni AI da questioni di fede a un duro esame di monetizzazione.

La spesa di capitale per l'AI si trova in un dilemma: accelerare mette sotto pressione il flusso di cassa, rallentare compromette la storia di crescita
Nomura Securities ritiene che la narrativa sugli investimenti in AI sia attualmente immersa in una contraddizione interna: se i grandi provider di cloud accelerano la spesa in capitale, il flusso di cassa libero continuerà a essere consumato e la sostenibilità del finanziamento sarà messa in discussione; se rallentano, ciò implica che le aspettative sulla domanda e sulla redditività dell’AI non saranno soddisfatte. Entrambe le strade portano a vendite. Le posizioni long accumulate durante il mercato "agenti intelligenti caldi" di settembre, quando attivate dai catalizzatori negativi, hanno causato massicce liquidazioni e si sono propagate verso i Treasury USA, il mercato valutario e quello delle materie prime, generando un deleveraging sistemico.

Il CEO di Amazon (AMZN.US): La capacità di cloud computing AWS è esaurita fino al 2027, e per il 2028 una grande parte della capacità è già stata prenotata dai clienti.
Venerdì, Jassy ha dichiarato che, con la crescente domanda di infrastrutture per l'intelligenza artificiale (AI), la capacità di cloud computing di Amazon AWS è praticamente esaurita fino al 2027, e per il 2028 una grande quantità di capacità è già stata prenotata dai clienti.

Il crollo del trading AI: Anthropic ritarderà la "super IPO"? La "data prevista per la quotazione" a metà novembre si avvicina.
La finestra temporale è estremamente stretta: secondo le regole della SEC, il file S-1 deve essere presentato al più tardi la prossima settimana e il mercato delle previsioni dà circa l’80% di probabilità di quotazione entro quest’anno. La vendita dei titoli nel settore AI ha gettato ombre sulle prospettive di quotazione, mentre il piano di settembre è già fallito. Diversi operatori di mercato affermano che Anthropic potrebbe subire pressioni per posticipare l’IPO, ma alcuni analisti sottolineano che la forte esigenza di capitale dell’azienda potrebbe spingerla a rispettare i tempi previsti.
Prezzi delle criptovalute
Altro


