
Chip server generasi berikutnya dari Intel, Diamond Rapids, diluncurkan, bertaruh pada era AI Agent

Intel secara resmi memamerkan prosesor server generasi berikutnya, Diamond Rapids, di Hot Chips 2026 dengan penawaran utama hingga 256 P-core dan arsitektur Fan-out Fabric terbaru, menargetkan infrastruktur AI Agent kelas enterprise dan menghadapi persaingan yang semakin sengit dari AMD dan Arm.
Diamond Rapids akan diproduksi menggunakan proses Intel 18A-P, mendukung bandwidth memori hingga 1,6TB/s, 128 jalur PCIe Gen 6 dan CXL 3.0, dengan jumlah inti yang meningkat lebih dari 50% dibanding generasi Xeon 6 sebelumnya. CEO Intel, Pat Gelsinger baru-baru ini mengisyaratkan bahwa karena kebutuhan workload AI Agent terhadap CPU terus meningkat, roadmap produk berikutnya kemungkinan akan dipercepat.
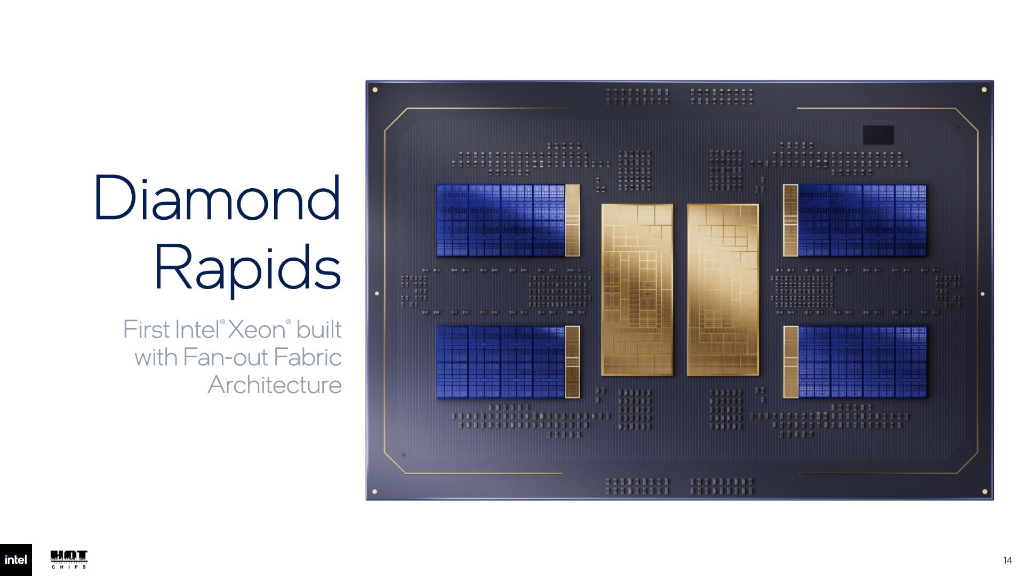
Kemunculan kali ini bertepatan dengan percepatan evolusi lanskap pasar CPU pusat data. AMD dengan seri EPYC Venice juga menawarkan prosesor 256-core "Zen 6", Nvidia juga memajukan strategi CPU dual-jalur berbasis x86 dan Arm, membuat dominasi Intel di pasar server semakin mendapat tekanan dari berbagai pihak.
Arsitektur Baru: Fan-out Fabric Merekonstruksi Desain Chip
Perubahan teknologi paling menonjol dari Diamond Rapids adalah diperkenalkannya CPU yang diklaim Intel sebagai "yang pertama menggunakan arsitektur Fan-out Fabric". Arsitektur ini membagi fungsi chip ke dalam empat modul utama: Scalable Compute Building Blocks, centralized I/O dan Memory Fabric Hub, Unified Memory Fabric, serta Flexible I/O Fabric.
Dari sisi konstruksi fisik, seluruh chip terdiri dari 22 dies independen yang dihubungkan, mencakup 16 core chiplet berbasis Intel 18A-P, 2 Fabric Hub berbasis Intel 3, dan 4 base tile berbasis Intel 3-T, masing-masing dihubungkan menggunakan Foveros Direct 3D bonding dan UCIe-S copper interconnect. Konsep desain ini sangat mirip dengan AMD EPYC Venice yang menggunakan multi-CPU chiplet di sekitar base I/O die besar.
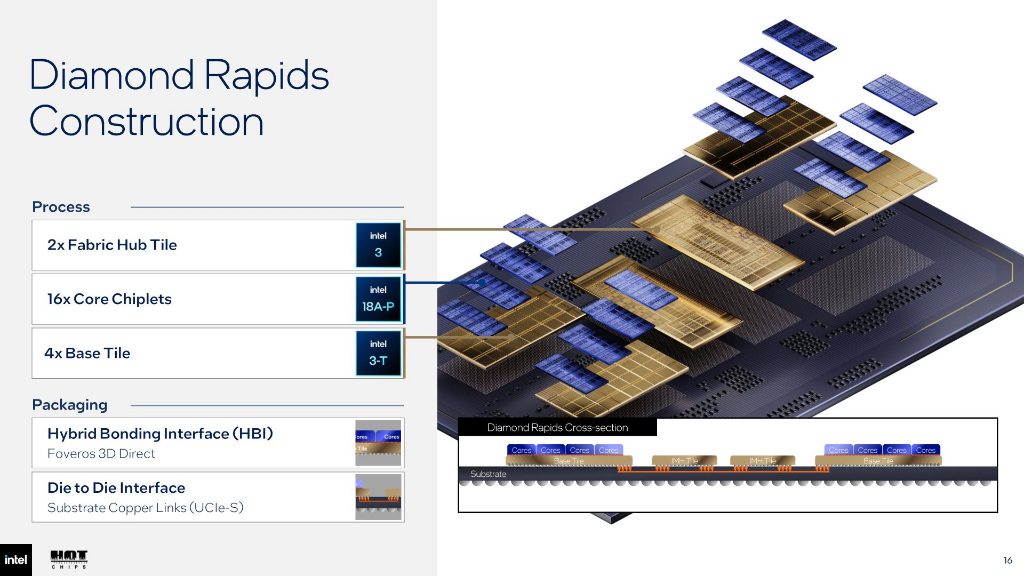
Dibanding Granite Rapids sebelumnya, perbedaan utama pada Diamond Rapids adalah pemisahan memory controller dari compute chiplet dan dialokasikan secara khusus ke Fabric Hub, sehingga memperbesar fleksibilitas ekspansi. Setiap Scalable Compute Block terdiri dari 16 core, dan dilengkapi 3D Xbar untuk menghubungkan core ke Last Level Cache (LLC) di base tile. Secara total, chip ini memiliki LLC 1,28GB, dengan setiap base tile membawa 320MB.
Spesifikasi Inti: 256 Core Setara AMD, Bandwidth Memori Melonjak Tajam
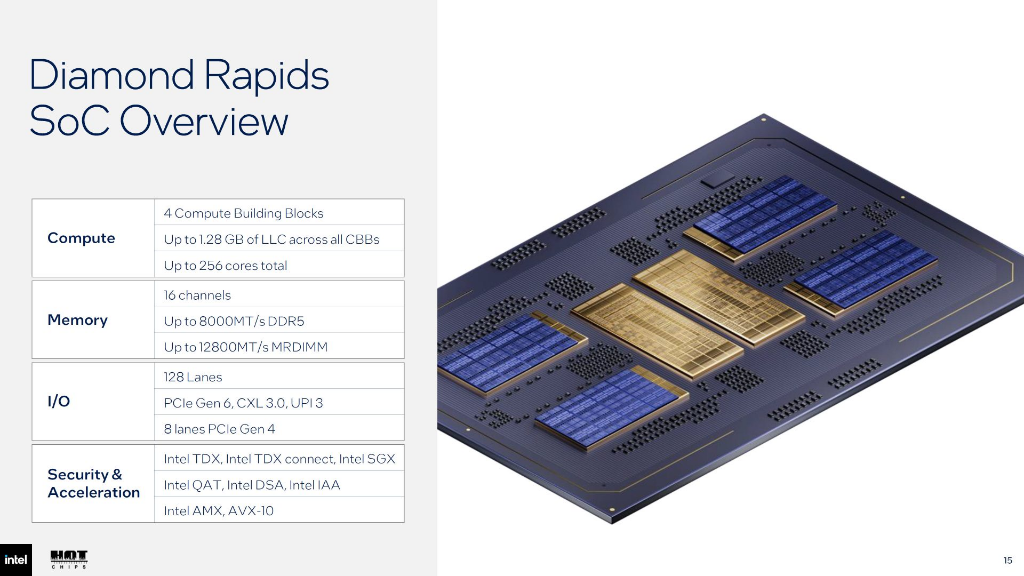
Dari sisi jumlah inti, konfigurasi tertinggi Diamond Rapids mencapai 256 P-core berbasis arsitektur Panther Cove-X, terdiri dari empat blok compute yang masing-masing memiliki empat core chiplet. Ini dua kali lipat dari Xeon 6 yang maksimal 128 core dan setara dengan AMD EPYC Venice yang memiliki 256 core.
Dalam subsistem memori, Diamond Rapids mendukung desain 16 channel, dapat bekerja hingga 12.800 MT/s menggunakan MRDIMMs dan 8.000 MT/s untuk DDR5 standar, menjangkau bandwidth memori puncak 1,6TB/s. Pada sisi I/O, chip menyediakan 128 jalur PCIe Gen 6 dan mendukung CXL 3.0 untuk kebutuhan ekspansi pada skenario storage dan jaringan yang intensif. Selain itu, chip ini juga menghadirkan Advanced Performance Extensions (APX) dan Advanced Matrix Extensions (AMX) generasi baru guna mempercepat inferensi AI dan komputasi matriks.
Hal penting yang perlu dicatat, Diamond Rapids tidak mendukung teknologi hyper-threading (SMT), fitur ini baru akan kembali di produk penerus, Coral Rapids. Dari sisi platform, chip menggunakan soket LGA 9324 dan TDP maksimal mencapai 650W.
Roadmap Produk: Coral Rapids Dipercepat, SKU Khusus Nvidia Dalam Pengembangan
Dari sisi perencanaan produk, setelah Diamond Rapids, Intel merencanakan Coral Rapids yang diprediksi hadir pertengahan 2028, akan membawa kembali dukungan SMT dan memakai platform memori 8 channel. Pat Gelsinger baru-baru ini menyampaikan bahwa meningkatnya kebutuhan workload AI Agent pada prosesor umum membuat timeline produk ini berpotensi dipercepat. Menariknya, sebelumnya Intel sempat merencanakan versi 8 channel untuk Diamond Rapids namun akhirnya dibatalkan dan fokus pada versi 16 channel.
Dari sisi kompetisi dan kolaborasi, Intel kini bekerja sama dengan Nvidia untuk membuat SKU x86 custom dengan interface NVLink yang disebut sedang dikembangkan untuk dikirimkan ke Nvidia. Hal ini menunjukkan bahwa arsitektur Xeon milik Intel akan langsung menjadi bagian dari strategi diversifikasi CPU Nvidia. Di saat bersamaan, Intel juga akan berkompetisi secara langsung dengan Nvidia Vera dan AMD Venice di pasar CPU pusat data.
Strategi utama Intel adalah: era AI Agent akan mengangkat kembali nilai strategis prosesor umum dalam infrastruktur AI, sehingga memperluas ruang pasar untuk seri Xeon. Apakah strategi ini akan terwujud sangat tergantung pada jadwal produksi massal dan performa pengiriman nyata dari Diamond Rapids.
Disclaimer: Konten pada artikel ini hanya merefleksikan opini penulis dan tidak mewakili platform ini dengan kapasitas apa pun. Artikel ini tidak dimaksudkan sebagai referensi untuk membuat keputusan investasi.
Kamu mungkin juga menyukai
Kepala Meta AI Alexandr Wang: Mengapa Saya Membuat Muse
Muse meraih 2,8 juta unduhan dalam 12 hari setelah peluncuran, melampaui kinerja ChatGPT pada periode yang sama, dan mencatatkan rekor harian 264 ribu unduhan di Amerika Serikat—Meta pun mengalami lonjakan nilai pasar sebesar 234 miliar dolar. Di balik fenomena ini, terdapat surat terbuka dari Chief AI Officer Alexandr Wang yang membahas "kerinduan manusia," serta akuisisi Meta senilai 14,3 miliar dolar yang dulu diejek sebagai "gila" oleh Mark Zuckerberg; kini, tampaknya itu adalah salah satu investasi talenta termurah dalam sejarah Silicon Valley.
UBS: Mempertahankan peringkat "netral" untuk Tesla (TSLA.US), target harga 385 dolar AS, narasi AI mendominasi logika penetapan harga saham
UBS memprediksi bahwa jumlah pengiriman global Tesla pada kuartal ketiga tahun 2026 (3Q26) diperkirakan sekitar 470.000 unit, turun 5% secara tahunan dan turun 1% secara kuartalan.
Gelombang AI bertahan menghadapi "imbal hasil obligasi AS 5%"! Nasdaq mencapai rekor baru memperkuat pola "80/20", Wall Street mengevaluasi ulang rasio saham dan obligasi
Imbal hasil obligasi pemerintah AS tenor 30 tahun sempat menyentuh sekitar 5,53%, tertinggi sejak tahun 2004, sementara harga minyak Brent masih berada di atas $100 per barel. Aset berisiko kembali bertahan menghadapi tekanan, mencerminkan bahwa para investor masih percaya bahwa komersialisasi aplikasi AI dan pertumbuhan keuntungan perusahaan dapat mengimbangi dampak kenaikan biaya pendanaan dan tingkat diskonto sampai batas tertentu.
Infrastruktur AI menghadapi "tembok"! Marvell: koneksi tembaga dan hambatan memori menjadi kunci ekspansi daya komputasi tahap berikutnya
Kompetisi kekuatan AI sedang berkembang menjadi permainan sistem yang mencakup interkoneksi dan memori. Eksekutif Marvell menyatakan bahwa model inferensi telah mendorong pertumbuhan cache KV sekitar 10 kali lipat dalam sembilan bulan terakhir, memori dalam satu rak tunggal tidak lagi memadai, koneksi tembaga mendekati batas, sehingga interkoneksi optik dan ekspansi memori menjadi inti dari ekspansi kekuatan komputasi. Kustomisasi telah menjadi tren industri, Marvell memperoleh keuntungan melalui simulasi SerDes, memori jaringan fotonik, dan kustomisasi seluruh rantai koneksi.
Harga kripto
Lainnya


