
Tian Yuandong: Jahresendbericht 2025 (Teil 1)
Bericht von Xinzhiyuan
Bericht von Xinzhiyuan
【Xinzhiyuan Überblick】Vom Retter für Llama 4 bis zur eigenen Kündigung und jetzt zum eigenen Startup blickt der KI-Experte Tian Yuandong auf einige wichtige Momente des Jahres 2025 zurück.
In letzter Zeit war ich zu beschäftigt, daher konnte ich meinen Jahresrückblick erst nach dem 1. Januar schreiben. Wie auch immer, Hauptsache, ich habe begonnen.
Als ich Ende Januar 2025 gebeten wurde, dem Llama4-Team zur Hilfe zu kommen, habe ich als jemand, der sich schon immer mit Reinforcement Learning beschäftigt hat, im Vorfeld eine 2x2 Reward-Matrix erstellt, um vier mögliche Szenarien durchzurechnen (obwohl es damals aufgrund des großen Drucks von oben fast unmöglich war, abzulehnen):
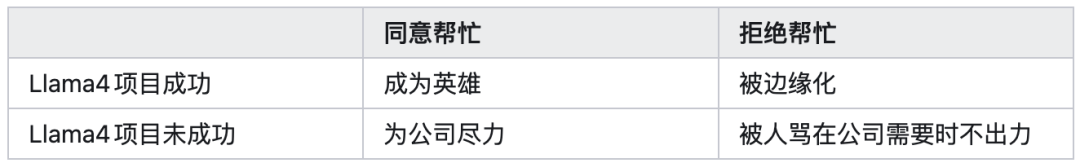
Damals dachte ich, dass wir zumindest unser Bestes geben würden, selbst wenn das Projekt am Ende scheitert, sodass wir ein reines Gewissen haben. Leider geschah letztlich eine fünfte Möglichkeit, die ich nicht einkalkuliert hatte. Das hat mir die Komplexität der Gesellschaft noch einmal deutlich vor Augen geführt.
Trotzdem konnten wir während der monatelangen Arbeit einige Kernfragen des Reinforcement Learning untersuchen, zum Beispiel Trainingsstabilität, Interaktionen zwischen Training und Inferenz, Modellarchitektur, Zusammenarbeit von Pretraining und Midtraining, Algorithmen für lange Denkprozesse, Methoden der Datengenerierung, das Design von Post-Training-Frameworks usw.
Diese Erfahrung war sehr wertvoll und hat meine Forschungsrichtung stark beeinflusst.
Ich hatte ohnehin schon darüber nachgedacht, dass ich nach über zehn Jahren im Unternehmen irgendwann gehen würde – man kann ja nicht ewig dortbleiben. Aber aus wirtschaftlichen und familiären Gründen blieb ich immer noch.
In den letzten ein bis zwei Jahren habe ich mit einer Art „Kündigt mich doch endlich!“-Mentalität gearbeitet und gesprochen, was mich tatsächlich entspannter gemacht hat.
Als ich Ende 2023 meinen ersten langen Urlaub nahm, war ich fast schon dabei zu gehen, aber ich unterschrieb nicht und entschied mich, zu bleiben. Es war also wirklich nicht einfach, die Entscheidung zum Gehen zu treffen. Im Nachhinein war es also gar nicht schlecht, dass Meta mir dabei geholfen hat.
Diese Turbulenzen und die Höhen und Tiefen dieses Jahres haben mir auch viel neues Material für meine künftigen Romane geliefert.
Wie es so schön heißt: „Scheitert die Karriere, gedeiht die Dichtkunst; erst in der Melancholie entstehen gute Verse.“ Ist das Leben allzu ruhig, fehlt vielleicht auch der Reiz. Ich erinnere mich noch an den Anfang von 2021, als ich in meinem Jahresrückblick ein paar kritische Anmerkungen zu den fehlenden Paper-Annahmen machte und dafür prompt ein Meet Most erhielt – das war ein Gefühl, plötzlich durchzufallen.
Aber anstatt mich zu beklagen, habe ich beschlossen, mich einfach so zu geben, als wäre ich eben befördert worden – und tatsächlich wurde ich ein halbes Jahr später befördert. Und das damals unbeachtete Paper aus Anfang 2021 erhielt im Juli 2021 eine ICML Best Paper Honorable Mention und wurde zu einem bekannten Beitrag im Bereich Representation Learning.
In der Zeit nach dem 22. Oktober waren meine Kommunikationskanäle fast überlastet: unzählige Nachrichten, E-Mails, Einladungen zu Meetings oder Treffen – ich kam kaum hinterher.
Erst einige Wochen später kehrte Normalität zurück. Ich danke allen für ihre Fürsorge und ihr Interesse in diesen zwei Monaten. Wenn ich damals auf Nachrichten nicht rechtzeitig geantwortet habe, bitte ich um Nachsicht.
Obwohl ich am Ende viele Angebote hatte und auch bekannte Unternehmen Kontakt zu mir aufnahmen, habe ich mich entschieden, solange ich noch jung bin, Mitgründer eines neuen Startups zu werden. Die Details werden vorerst nicht veröffentlicht – ich arbeite erstmal ruhig weiter.
Die Hauptthemen für 2025 sind einerseits das Reasoning mit großen Modellen, andererseits das Öffnen der Blackbox der Modelle.
Seit unsere Arbeit zum kontinuierlichen latenten Raum-Reasoning (coconut, COLM’25) Ende 2024 veröffentlicht wurde, hat dieses Thema 2025 einen regelrechten Boom ausgelöst. Forscher untersuchen, wie man diese Idee im Reinforcement Learning und Pretraining nutzt, wie man Effizienz bei Training und Berechnung steigert usw.
Obwohl unser Team dann zu Llama abgezogen wurde und wir uns nicht weiter intensiv damit beschäftigen konnten, freut mich das sehr.
Wir haben dennoch in der ersten Jahreshälfte eine theoretische Analyse (Reasoning by Superposition, NeurIPS‘25) veröffentlicht, die aufzeigt, wo die Vorteile des kontinuierlichen latenten Raum-Reasonings liegen – und viel Aufmerksamkeit bekam.
Ein weiteres Thema ist, wie man die Effizienz des Reasonings mit großen Modellen steigert. Unsere Arbeit Token Assorted (ICLR’25) nutzt VQVAE, um diskrete Token im latenten Raum zu lernen und diese zusammen mit Text-Token weiterzutrainieren, was die Inferenzkosten senkt und die Leistung erhöht.
DeepConf misst das Vertrauen in jedes generierte Token, um zu entscheiden, ob ein Reasoning-Pfad frühzeitig abgebrochen wird. Dadurch werden deutlich weniger Token für Inferenz benötigt, aber die Leistung ist bei Majority Vote sogar besser.
ThreadWeaver erzeugt parallele Reasoning-Ketten und trainiert darauf weiter, um die Geschwindigkeit zu erhöhen. Außerdem trainieren wir auf dLLM Reasoning-Modelle mit RL (Sandwiched Policy Gradient), und es gibt Versuche, Reasoning auf kleinen Modellen zu lernen (MobileLLM-R1).
Im Bereich Interpretierbarkeit beobachte ich das Thema Grokking (Erleuchtung) schon seit etwa zwei Jahren. Bei meinen früheren Analysen zum Representation Learning konnte ich zwar den Dynamikprozess des Lernens nachvollziehen und Ursachen für Kollaps-Erscheinungen bestimmen, aber was genau gelernt wird, wie das mit der Datenstruktur zusammenhängt und welche Generalisierungsfähigkeit daraus resultiert, blieb unklar. Die Analyse des Grokking-Phänomens, also des plötzlichen Übergangs von Erinnerung zu Generalisierung, könnte dieses Rätsel lösen.
Anfangs war es wirklich schwierig und es fehlte an Ansätzen – 2024 entstand zunächst COGS (NeurIPS‘25, siehe „Suchende fragen nicht nach Sommer oder Winter (10)“), das aber nur Spezialfälle analysiert und mich nicht zufriedenstellt.
Nach über einem Jahr Unsicherheit und vielen Interaktionen mit GPT5 gab es mit dem aktuellen Beitrag Provable Scaling Laws einen Durchbruch: Damit konnten wir Dinge analysieren, die mit der bisherigen linearen Struktur (NTK) nicht sichtbar waren, und die Trainingsdynamik der Feature-Emergenz besser erklären. Die analysierten Fälle sind zwar immer noch speziell, aber zumindest wurde ein neues Fenster geöffnet. Details dazu unter „Gedanken von Tian Yuandong“.
Der Artikel zum Jahresende The path not taken gefällt mir sehr, da er aus der Perspektive der Gewichtungsebene eine erste Antwort auf die Frage gibt, warum sich das Verhalten von RL und SFT so stark unterscheidet.
SFT führt zu Overfitting und katastrophalem Vergessen (catastrophic forgetting), weil das Training nicht ausreichend on-policy ist. Der tieferliegende Grund ist, dass die Hauptkomponenten der Gewichte durch fremde Daten stark verändert werden, was die „Basis“ destabilisiert und die Modellleistung drastisch verschlechtert.
RL hingegen nutzt on-policy Daten, sodass die Hauptkomponenten der Gewichte erhalten bleiben und nur die Nebenkomponenten verändert werden – dadurch lässt sich das katastrophale Vergessen vermeiden und die veränderten Gewichte sind oft sparsamer verteilt (insbesondere bei bf16-Quantisierung).
Viele halten Interpretierbarkeit oder die Frage „Warum funktioniert KI so gut?“ für unwichtig – ich hingegen halte sie für sehr wichtig. Stellen wir uns zwei Szenarien vor:
Szenario 1: Wenn wir allein durch Scaling AGI oder sogar ASI erreichen, wird der menschliche Arbeitswert auf null gesetzt, und KI löst als riesige Blackbox alle Probleme. Dann ist es dringend, dafür zu sorgen, dass KI als Superintelligenz immer Gutes tut und nicht auf verdeckte Weise Böses – und das geht nur mit Interpretierbarkeit.
Szenario 2: Sollte Scaling letztlich versagen, muss die Menschheit bei exponentiell steigendem Ressourcenbedarf Alternativen suchen. Dann müssen wir uns fragen: „Warum funktionieren Modelle, und wann versagen sie?“ – und genau diese Überlegungen führen zurück zur Forschung, bei der Interpretierbarkeit der nächste Schritt ist.
In beiden Fällen braucht es am Ende Interpretierbarkeit, um die Situation zu retten. Selbst wenn KI am Ende ein allwissender, allmächtiger, allgütiger Gott wäre – aus menschlicher Neugier und Forscherdrang würden wir trotzdem wissen wollen, warum KI so gut funktioniert.
Schließlich bedeutet „Blackbox“ die Entstehung einer Kette von Verdacht. In einer Zeit, in der große Modelle explodieren und das menschliche Durchschnittsniveau erreichen oder übertreffen, könnten die Regeln des „Dunklen Waldes“ aus „Die drei Sonnen“ auf neue Weise Wirklichkeit werden.
Aktuell sind wir beim Öffnen der trainierten Blackbox-Modelle und beim Finden von Schaltkreisen (circuits) noch in einem sehr frühen Stadium.
Die eigentliche Herausforderung bei der Interpretierbarkeit besteht darin, von den ersten Prinzipien aus – also von Modellarchitektur, Gradientenabstieg und der inhärenten Struktur der Daten – zu erklären, warum Modelle entkoppelte, sparsame, niedrig-rangige, modulare und kombinierbare Features und Schaltkreise lernen, warum es so viele verschiedene Erklärungen gibt, wie diese emergenten Strukturen mit Trainings-Hyperparametern zusammenhängen usw.
Sobald wir die Notwendigkeit der Feature-Emergenz großer Modelle direkt aus den Gleichungen des Gradientenabstiegs ableiten können, wird Interpretierbarkeit vom biologischen Evidenzsammeln zur physikalischen Prinzipienableitung – und kann so die Praxis leiten und den Weg für die nächste Generation von KI-Modellen ebnen.
Vergleicht man das mit der Physik vor 400 Jahren, so gibt es heute viele „Tycho Brahes“ der KI (Datensammler), einige „Keplers“ (Hypothesensteller), aber noch keinen „Newton“ (Prinzipienfinder).
Wenn dieser Tag kommt, glaube ich, wird die Welt auf den Kopf gestellt.
Haftungsausschluss: Der Inhalt dieses Artikels gibt ausschließlich die Meinung des Autors wieder und repräsentiert nicht die Plattform in irgendeiner Form. Dieser Artikel ist nicht dazu gedacht, als Referenz für Investitionsentscheidungen zu dienen.
Das könnte Ihnen auch gefallen
KI "fällt", US-Staatsanleihen "sind satt"! Globaler "Kapitalwettstreit", der Markt gibt die Antwort
Die enormen Kapitalausgaben der führenden KI-Unternehmen haben eine Vertrauenskrise am Markt ausgelöst. Der Nasdaq verzeichnete die schlechteste Zwei-Wochen-Performance der letzten Jahre, während ein Korb von KI-bezogenen Aktien innerhalb einer Woche um 4,9 % einbrach. Gleichzeitig erlebten US-Staatsanleihen eine starke Kehrtwende, die Rendite 10-jähriger Anleihen fiel unter 5 %, und Anleihen-ETFs zogen im vergangenen Monat 58 Milliarden US-Dollar an. Die Expansion der KI und die staatliche Defizitfinanzierung konkurrieren um das begrenzte Kapital; die Logik der Ära des billigen Kapitals wird derzeit neu geschrieben.
Nahezu Monopol auf “Hormus-Öltransporte”! Dieser südkoreanische Reeder ist „über Nacht reich geworden“, nachdem er zuvor 73 gebrauchte Supertanker für 6 Milliarden US-Dollar gehortet hatte.
Die südkoreanische HMM sicherte sich im September dieses Jahres nahezu 40 % des Öltransits durch die Straße von Hormus und übertraf in den ersten zehn Tagen des Oktobers sogar 50 %. Das monatliche Transportvolumen lag damit höher als das der Eigner aus den drei größten Ländern – Saudi-Arabien, Kuwait und den Vereinigten Arabischen Emiraten – zusammen. Durch hochpreisige „Anschlussgeschäfte“ erzielte HMM enorme Chartereinnahmen. Unterstützt wird das Unternehmen dabei durch eine Beteiligung der weltweit größten Reederei MSC, die der Flotte Rückhalt gibt. Die Flottengröße beträgt inzwischen 162 Schiffe, womit HMM zum weltweit größten Betreiber von Öltankern aufgestiegen ist.
Gold fällt unter 4000 US-Dollar, der Yen steigt auf Widerstandsniveau – der Markt wird wählerisch bei „sicheren Häfen“
Gold fiel in dieser Woche unter 4.000 US-Dollar und erreichte ein Drei-Monats-Tief, während die globale Risikoaversion zunimmt und der Kursverlauf von US-Staatsanleihenrenditen abweicht. Analysten führen die Schwäche von Gold auf das Nachlassen der Spekulationsattribute im letzten Jahr sowie auf die verstärkten Zinserhöhungserwartungen zurück. Gleichzeitig hat sich der Yen, dank einer etwa 40%igen Unterbewertung, zum bevorzugten Absicherungsinstrument von Goldman Sachs entwickelt – das traditionelle Gefüge sicherer Anlagen wird damit stillschweigend neu gestaltet.
Nach einer Woche der Krise eine Atempause! Frankreich entgeht vorerst einer Herabstufung durch Moody’s
Moody's hat das Rating für Frankreich, die zweitgrößte Volkswirtschaft der Eurozone, bei Aa3 belassen, was sieben Stufen über dem „Ramschniveau“ liegt und dem Rating des Vereinigten Königreichs entspricht; der Ausblick für das Rating bleibt negativ.
Krypto-Preise
Mehr


